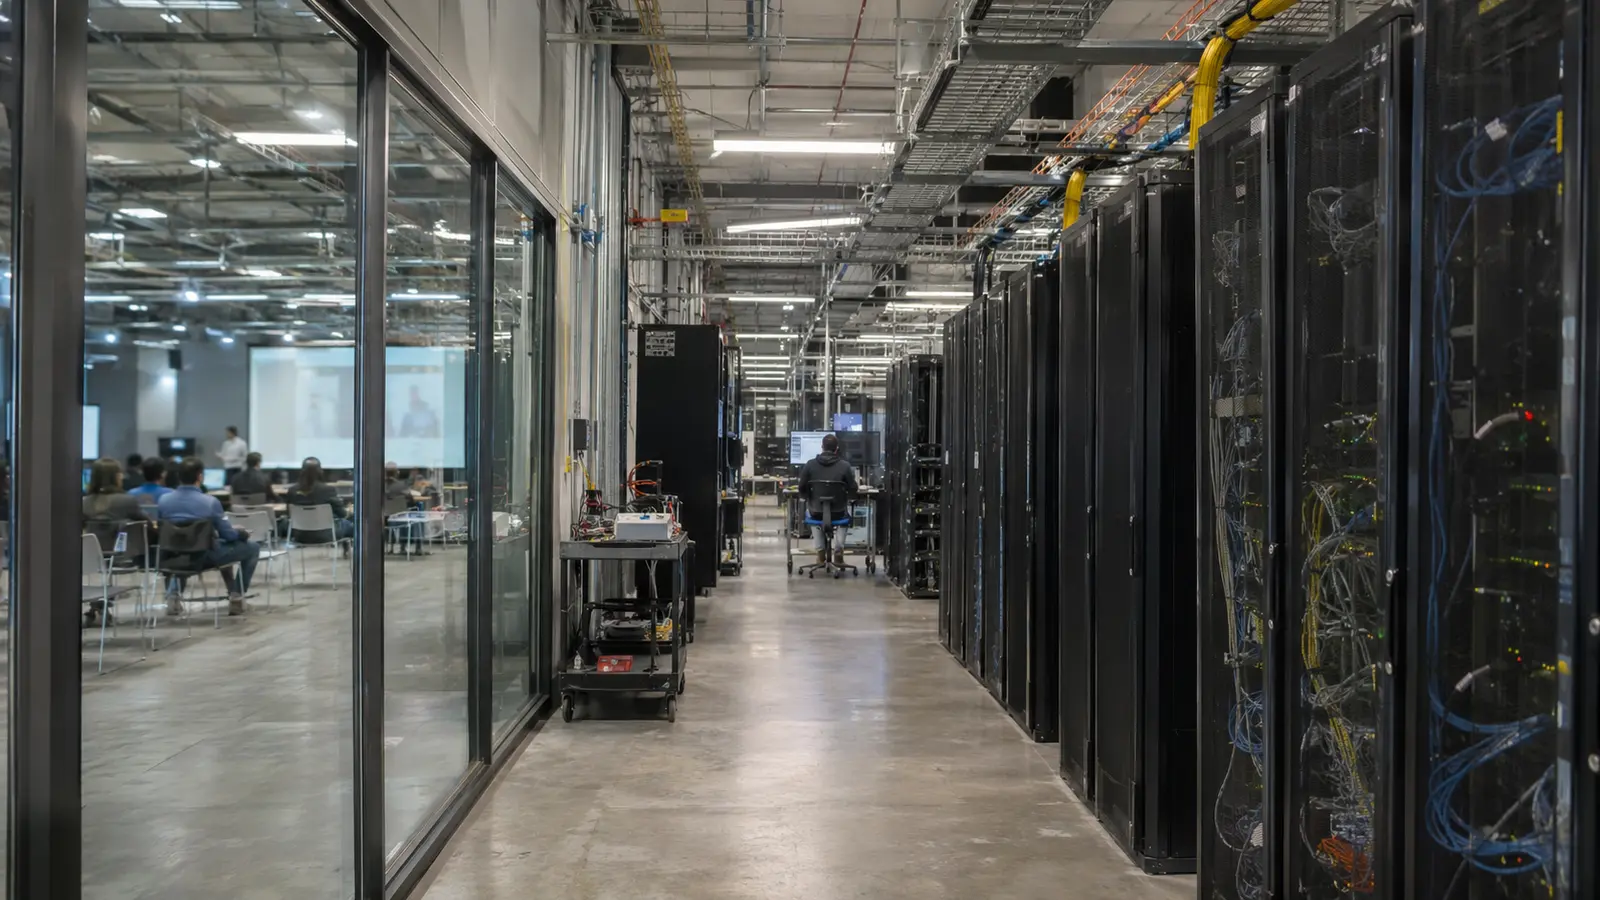
A Lambda está usando switches com óptica co-empacotada (CPO) da NVIDIA Photonics para conectar racks NVIDIA GB300 NVL72 com mais de 10 mil GPUs em uma AI factory. Segundo a NVIDIA, nos testes da provedora a latência de rede caiu cerca de 4% em escala de rack e até cerca de 10% em escala de pod, com a mesma vazão da óptica plugável convencional. A NVIDIA afirma ainda que a tecnologia entrega até 5x mais eficiência energética e até 15x mais confiabilidade que transceptores plugáveis, além de usar 4x menos lasers.
A Lambda está usando switches com óptica co-empacotada (CPO) da NVIDIA Photonics para conectar racks NVIDIA GB300 NVL72 com mais de 10 mil GPUs em uma AI factory. A informação é da NVIDIA, que publicou o caso em seu blog e atribui à provedora de nuvem a decisão de adotar a tecnologia em escala.
O argumento central é simples: treinar um modelo de IA exige que milhares de GPUs trabalhem juntas, e isso depende de uma rede rápida, eficiente e resiliente. Segundo a NVIDIA, a Lambda está atacando justamente a parte de rede desse quebra-cabeça.
O que muda com a óptica co-empacotada
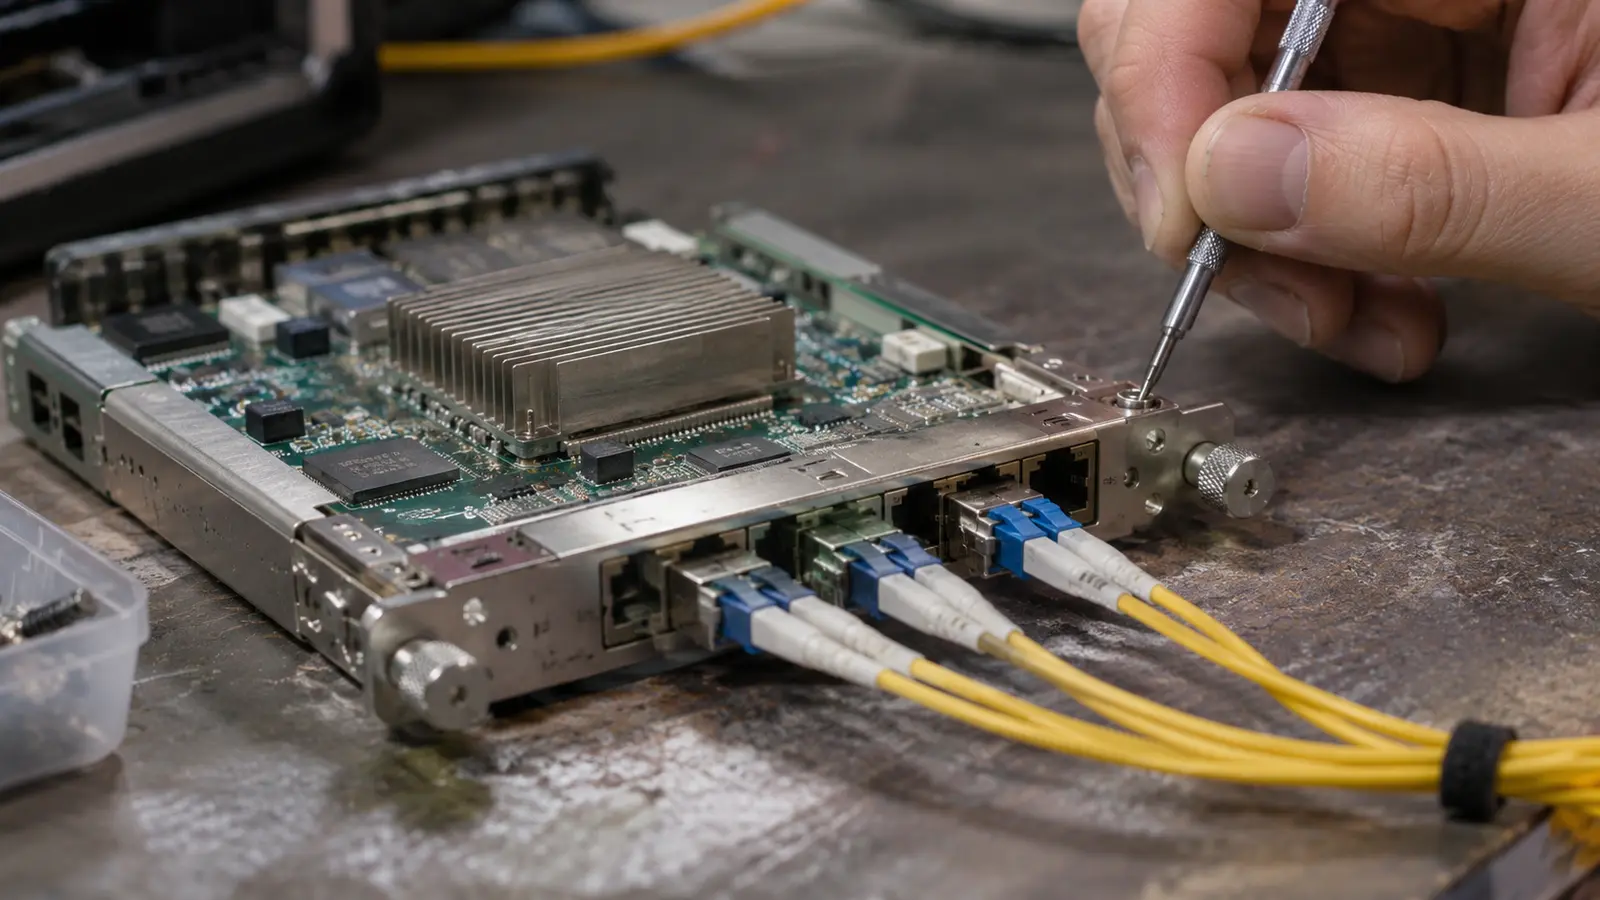
Na abordagem tradicional, os transceptores ópticos são plugáveis e ficam separados do chip do switch. Com a CPO, os motores ópticos ficam no mesmo pacote do chip, o que encurta o caminho elétrico de polegadas para milímetros, reduz a perda de sinal e elimina a necessidade de chips de retimer, cortando consumo e número de componentes no caminho do sinal.
A NVIDIA afirma que, ao substituir transceptores plugáveis por motores ópticos co-empacotados no pacote do switch, a tecnologia entrega até 5x mais eficiência energética e até 15x mais confiabilidade que a óptica plugável convencional. A empresa também diz que o desenho usa 4x menos lasers, o que significa menos componentes sujeitos a falha.
Cada switch usado pela Lambda tem 144 portas a 800Gb/s, segundo a NVIDIA. O resfriamento é líquido e leva calor para longe do chip do switch e dos motores ópticos.
Latência, temperatura e manutenção em campo
Nos testes da Lambda com os switches, relatados pela NVIDIA, a latência de rede caiu cerca de 4% em escala de rack e até cerca de 10% em escala de pod. Em configurações de rack, unidade escalável e pod, a rede manteve a mesma vazão da óptica plugável convencional, de acordo com a publicação.
A NVIDIA informa que a Lambda reportou temperatura mediana da óptica de 36°C, contra 51°C na óptica plugável convencional, e que os testes encontraram integridade de sinal mais estável. A publicação não detalha a metodologia completa dessas medições nem o período exato de coleta.
Outro ponto destacado é a manutenção. Cada switch tem 18 fontes de luz externas removíveis, que alimentam os motores ópticos. Técnicos podem trocar os módulos de fonte de luz em campo, diferente da óptica plugável tradicional, em que a falha de um laser exige a substituição do módulo inteiro.
A NVIDIA sustenta que eficiência energética e resiliência importam porque a rede está no centro da produtividade de uma AI factory. Em um grande job de treinamento, um único link interrompido pode travar milhares de GPUs. Em inferência agêntica, uma interrupção de rede pode gerar efeitos cascateados de latência em muitos agentes. Cada interrupção custa tempo, e cada watt gasto em rede é um watt que não sobra para computação.
O que ainda não está claro
Os números divulgados vêm da NVIDIA e da própria Lambda, sem detalhamento público, no material fornecido, sobre a configuração completa dos testes, o tamanho exato dos pods ou as condições de carga em que as medições foram feitas. Os ganhos de latência de cerca de 4% e até cerca de 10% são apresentados como resultados dos testes da Lambda, não como benchmark independente.
Também não há, no texto da NVIDIA, informação sobre custo de implantação, prazo de disponibilidade comercial ampla ou comparação com outras abordagens de rede para clusters de IA. A declaração de Dave Ward, presidente de serviços de nuvem da Lambda, resume a aposta: segundo ele, a rede precisa acompanhar a demanda de clusters de IA cada vez maiores, e levar óptica co-empacotada a um deployment dessa escala é um passo importante para a infraestrutura da próxima geração de IA.
Para quem acompanha infraestrutura de IA, o caso sinaliza uma disputa que vai além das GPUs: a rede passa a ser tratada como parte crítica do desempenho e da disponibilidade de uma AI factory, com impacto direto em consumo de energia e em tempo de operação.
Fonte original: NVIDIA: Lambda Boosts AI Factory Resiliency and Efficiency With NVIDIA Photonics.
Receba o Jornal da IA todos os dias
As notícias de inteligência artificial que importam no Brasil, com o nosso prisma e sempre com as fontes. Grátis.